Robots.txt là gì? Cách tạo và kiểm tra chuẩn SEO · VibeVPS
Robots.txt là gì? Cách tạo và kiểm tra đúng chuẩn SEO
Tìm hiểu robots.txt là gì, cách tạo tệp cơ bản và kiểm tra các quy tắc thu thập dữ liệu. Bài viết cũng hướng dẫn tránh chặn nhầm trang quan trọng khỏi công cụ tìm kiếm.
Robots.txt là một tệp nhỏ nhưng có thể ảnh hưởng đến cách công cụ tìm kiếm thu thập dữ liệu trên website. Chỉ cần một quy tắc viết sai, bạn có thể vô tình hạn chế bot truy cập vào trang hoặc tài nguyên cần thiết. Bài viết dưới đây giải thích robots.txt là gì, hướng dẫn tạo robots.txt cơ bản và cách kiểm tra robots.txt trước khi áp dụng.
Robots.txt là gì và có tác dụng gì?
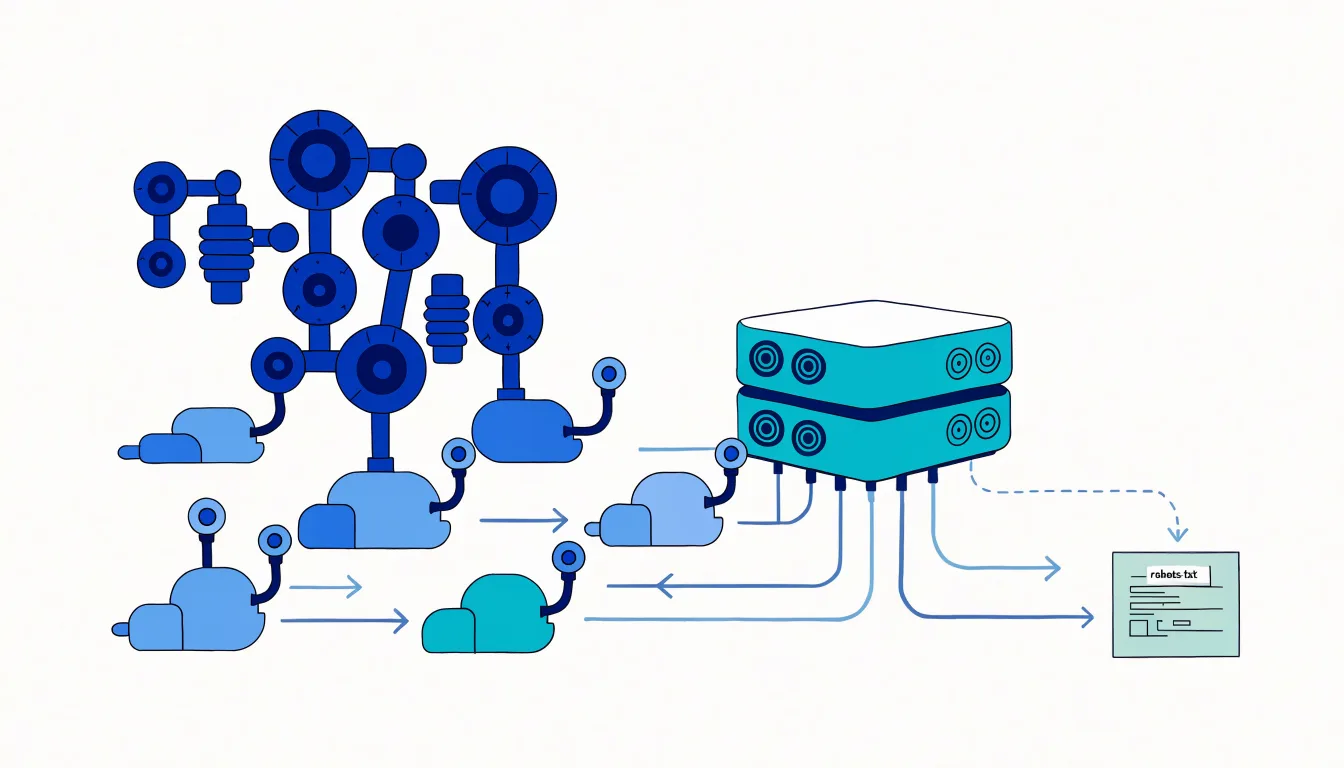
Bot công cụ tìm kiếm đọc tệp robots.txt trên máy chủ website
Robots.txt là tệp văn bản đặt ở thư mục gốc của một website, dùng để đưa ra hướng dẫn cho các trình thu thập dữ liệu của công cụ tìm kiếm. Bot sẽ kiểm tra tệp này trước khi truy cập các URL khác trên cùng một tên miền. Ví dụ, tệp thường có thể truy cập tại https://example.com/robots.txt.
Tệp robots.txt áp dụng cho một nguồn gốc cụ thể, tức là phạm vi giao thức, tên miền và cổng tương ứng. Vì vậy, https://example.com/robots.txt không tự động áp dụng cho phiên bản http, tên miền phụ www hoặc một tên miền khác. Nếu website có nhiều phiên bản cần quản lý, hãy kiểm tra robots.txt trên từng địa chỉ đang sử dụng.
Robots.txt thường được dùng để:
Hạn chế bot thu thập một số khu vực không cần xuất hiện trong quá trình crawl, chẳng hạn trang quản trị hoặc kết quả tìm kiếm nội bộ.
Cho bot biết những đường dẫn nào được phép truy cập bằng quy tắc Allow và đường dẫn nào không nên truy cập bằng Disallow.
Khai báo vị trí sitemap để bot dễ tìm thấy danh sách URL trên website.
Điều quan trọng là robots.txt không phải công cụ bảo mật. Quy tắc Disallow chỉ là yêu cầu bot tuân thủ, không khóa quyền truy cập của người dùng hay ngăn mọi bot tự động. Nội dung riêng tư cần được bảo vệ bằng xác thực, phân quyền hoặc biện pháp bảo mật phù hợp; không nên dựa vào robots.txt.
Robots.txt cũng không đảm bảo một URL bị chặn sẽ biến mất khỏi kết quả tìm kiếm. Nếu URL được liên kết từ nơi khác, công cụ tìm kiếm vẫn có thể biết đến URL đó mà không đọc được nội dung. Khi cần yêu cầu không lập chỉ mục, hãy cân nhắc thẻ noindex hoặc tiêu đề HTTP phù hợp và bảo đảm bot có thể truy cập để đọc chỉ thị đó.
Cách tạo robots.txt cơ bản cho website
Lập trình viên tạo tệp robots.txt trong thư mục gốc website
Bạn có thể tạo tệp bằng một trình soạn thảo văn bản thuần như Notepad hoặc VS Code. Lưu tên chính xác là robots.txt, dùng văn bản thuần và tải tệp lên thư mục gốc của website, sao cho URL công khai có dạng https://tenmiencuaban.vn/robots.txt. Không lưu thành robots.txt.txt hoặc đặt tệp trong một thư mục con.
Hãy thay tenmiencuaban.vn và đường dẫn sitemap bằng thông tin thực tế của website. Nếu website không dùng WordPress, đừng giữ nguyên quy tắc /wp-admin/ một cách máy móc; hãy thay bằng đường dẫn phù hợp hoặc bỏ quy tắc đó. Khi chưa có nhu cầu hạn chế khu vực nào, một tệp đơn giản với khai báo sitemap, hoặc chưa thêm lệnh Disallow, thường an toàn hơn việc chặn rộng.
Hiểu các chỉ thị thường gặp
User-agent xác định bot được áp dụng quy tắc. * có nghĩa là áp dụng cho mọi bot hỗ trợ robots.txt. Có thể khai báo nhóm riêng cho một bot, nhưng cần kiểm tra đúng tên bot và quy tắc của nhóm đó.
Disallow chỉ định đường dẫn bot không nên thu thập. Ví dụ Disallow: /tim-kiem/ nhắm đến URL bắt đầu bằng đường dẫn đó.
Allow cho phép một đường dẫn cụ thể trong khu vực bị hạn chế. Ví dụ trong mẫu trên, trang admin-ajax.php được cho phép dù thư mục /wp-admin/ bị hạn chế.
Sitemap khai báo URL đầy đủ của sitemap. Đây là chỉ dẫn hữu ích cho bot, không phải quy tắc chặn hay bảo đảm mọi URL trong sitemap sẽ được lập chỉ mục.
Một số bot, trong đó có Googlebot, hỗ trợ ký tự đại diện * và ký hiệu $ để mô tả mẫu đường dẫn. Tuy nhiên, không nên cho rằng mọi trình thu thập đều xử lý các ký hiệu này giống nhau. Nếu website có cấu trúc phức tạp hoặc cần quy tắc cho nhiều bot, hãy đối chiếu tài liệu của bot mục tiêu.
Những lỗi cần tránh khi viết quy tắc
Không dùng Disallow: / nếu mục tiêu là để website được thu thập bình thường: quy tắc này yêu cầu bot không truy cập toàn bộ đường dẫn trên website. Cũng cần tránh chặn nhầm thư mục chứa trang sản phẩm, bài viết, CSS hoặc JavaScript cần thiết để hiển thị nội dung. Khi bot không tải được tài nguyên quan trọng, khả năng đọc và kết xuất trang có thể bị ảnh hưởng.
Đừng đưa mật khẩu, dữ liệu nhạy cảm hoặc đường dẫn riêng tư vào robots.txt với suy nghĩ rằng chúng sẽ được che giấu. Tệp này được công khai và bất kỳ ai cũng có thể mở. Ngoài ra, không tạo quá nhiều quy tắc theo cảm tính; mỗi dòng nên có mục đích rõ ràng và được kiểm tra với URL cụ thể.
Cách kiểm tra robots.txt sau khi tạo
Kiểm tra quy tắc cho phép và chặn bot thu thập dữ liệu
Sau khi tải tệp lên, hãy mở trực tiếp địa chỉ https://tenmiencuaban.vn/robots.txt trên trình duyệt. Kiểm tra xem tệp có hiển thị đúng nội dung, đúng tên miền và không bị chuyển hướng đến trang lỗi hay trang đăng nhập. Tệp nên được máy chủ trả về bình thường, không bị lỗi 404 hoặc lỗi máy chủ. Nếu vừa chỉnh sửa, hãy kiểm tra lại URL công khai thay vì chỉ xem bản lưu trên máy tính.
Tiếp theo, đối chiếu quy tắc với những URL quan trọng. Chọn một URL cần cho phép, chẳng hạn trang chủ hoặc một trang dịch vụ, và một URL thực sự cần hạn chế. Đọc từng nhóm User-agent, xác định chỉ thị tương ứng rồi xem đường dẫn URL có khớp quy tắc hay không. Bot có thể xử lý quy tắc cụ thể và quy tắc tổng quát theo thứ tự ưu tiên riêng; với Google, quy tắc khớp cụ thể hơn được ưu tiên, còn trường hợp tương đương có thể xét Allow. Đừng giả định mọi bot đều xử lý giống hệt nhau.
Dùng công cụ quản trị và kiểm tra bằng URL
Trong Google Search Console, bạn có thể dùng tính năng Kiểm tra URL để xem Google có thể truy cập URL hay không và kiểm tra trạng thái thu thập dữ liệu. Tính năng này hữu ích để phát hiện trang bị chặn, nhưng không thay thế việc đọc toàn bộ robots.txt. Giao diện công cụ có thể thay đổi theo thời gian; nếu cần kiểm tra cú pháp cho một bot cụ thể, hãy tham khảo tài liệu hiện hành của công cụ tìm kiếm đó.
Một cách kiểm tra thủ công là lấy đường dẫn sau tên miền và so sánh với các dòng Allow hoặc Disallow. Ví dụ, nếu có Disallow: /tim-kiem/, hãy thử đối chiếu URL https://tenmiencuaban.vn/tim-kiem/tu-khoa. Kiểm tra cả các biến thể quan trọng như thư mục con, URL có tham số và đường dẫn có chữ hoa nếu website sử dụng chúng. Đường dẫn trong quy tắc thường phân biệt chữ hoa, chữ thường; vì vậy /Tai-khoan/ không nhất thiết tương đương /tai-khoan/.
Sau mỗi lần thay đổi, hãy kiểm tra lại ít nhất một URL quan trọng thuộc mỗi nhóm quy tắc. Nếu website có nhiều tên miền phụ hoặc phiên bản giao thức, mở robots.txt trên từng phiên bản. Với website mới chuyển máy chủ, triển khai lại hoặc đổi cấu trúc URL, cần kiểm tra lần nữa vì tệp cũ có thể bị thay thế, còn cache hoặc cấu hình máy chủ có thể khiến nội dung hiển thị không như dự kiến.
Quy trình rà soát để tránh chặn nhầm nội dung
Trước khi áp dụng quy tắc, lập danh sách các khu vực cần bot truy cập: trang chủ, danh mục, bài viết, sản phẩm, trang dịch vụ và tài nguyên hiển thị nội dung. Sau đó ghi riêng những đường dẫn thực sự muốn hạn chế, chẳng hạn trang kết quả tìm kiếm nội bộ hoặc một khu vực quản trị không cần crawl. Không nên chặn toàn bộ thư mục chỉ vì trong đó có một URL không cần thu thập.
Bạn có thể rà soát theo các bước sau:
Tìm tất cả dòng Disallow và xác định chính xác đường dẫn bị ảnh hưởng.
Kiểm tra URL quan trọng có nằm trong thư mục bị chặn hoặc khớp mẫu ký tự đại diện hay không.
Xác nhận CSS, JavaScript và hình ảnh cần để kết xuất nội dung không bị chặn ngoài ý muốn.
Mở tệp robots.txt công khai và kiểm tra các URL đại diện sau khi cập nhật.
Lưu bản sao cấu hình trước khi chỉnh sửa để có thể khôi phục nếu phát hiện lỗi.
Nếu trang đã bị loại khỏi kết quả tìm kiếm, đừng vội thêm Disallow. Trước tiên hãy xác định nguyên nhân: trang có thẻ noindex, trả về lỗi, bị trùng lặp hay chưa được liên kết phù hợp? Chặn bot khi đang cần bot đọc thẻ noindex có thể khiến quá trình xử lý không diễn ra như mong muốn. Robots.txt quản lý hoạt động crawl, còn việc lập chỉ mục phụ thuộc vào nhiều tín hiệu khác.
Câu hỏi thường gặp về robots.txt
Website có bắt buộc phải có robots.txt không?
Không phải website nào cũng cần quy tắc riêng. Nếu không có tệp, bot thường có thể thu thập dữ liệu theo cách thông thường, tùy chính sách của từng bot. Tạo tệp giúp bạn chủ động thể hiện hướng dẫn, nhưng một cấu hình đơn giản và chính xác tốt hơn một tệp dài với nhiều lệnh chưa được kiểm tra.
Có nên chặn trang quản trị bằng robots.txt không?
Bạn có thể hạn chế bot thu thập khu vực quản trị nếu phù hợp, nhưng robots.txt không bảo vệ khu vực đó khỏi người truy cập. Hãy dùng đăng nhập, phân quyền và cấu hình bảo mật. Cũng cần kiểm tra website có tài nguyên hoặc chức năng công khai nào nằm trong cùng thư mục cần được phép truy cập hay không.
Sửa robots.txt bao lâu thì có hiệu lực?
Sau khi tệp được cập nhật, bot cần quay lại đọc tệp và thu thập dữ liệu theo lịch riêng. Thời điểm áp dụng có thể khác nhau, vì vậy không nên coi thay đổi là tức thời. Hãy xác nhận nội dung mới đã được máy chủ phục vụ đúng và tiếp tục theo dõi trạng thái URL trong công cụ quản trị tìm kiếm.
Kết luận
Robots.txt là nơi đưa ra hướng dẫn crawl cho bot, không phải hàng rào bảo mật hay cách bảo đảm URL được lập chỉ mục. Để tạo robots.txt an toàn, hãy viết quy tắc ngắn gọn, xác định đúng phạm vi, tránh chặn tài nguyên quan trọng và kiểm tra URL công khai sau mỗi lần thay đổi. Nếu đang quản lý website, hãy dành thời gian rà soát tệp hiện tại trước khi thêm lệnh mới; một lần kiểm tra cẩn thận có thể giúp tránh ảnh hưởng ngoài ý muốn đến nội dung quan trọng.
Hướng dẫn nhập địa chỉ, cổng và thông tin xác thực Proxy IPv4 trên Windows 10, Windows 11. Thực hiện vài bước kiểm tra để biết thiết bị đã truy cập Internet qua proxy hay chưa.